把时间序列按“快慢”切开:低通滤波入门
1 前言
最近在读时间序列方向的论文,"低通""频域""频带""平滑"这些词出现的频率不低。但是,我毕竟不是做这个方向的,作为学安全出身的,对信号处理这些不是很熟悉。
所以我稍微整理了一下一些知识点,出一个博客。本文主要讲:低通滤波。
2 一个序列是不同快慢成分的叠加
知识点:什么是时间序列?什么是多变量?
按时间顺序记录的一串数值就是时间序列:每分钟记一次的服务器 CPU 利用率,每秒采一次的传感器读数。只记一个量,叫单变量;同时记录 M 个量——一台服务器的几十个指标、一颗卫星几百个遥测参数——每个量各有一条曲线,就是多变量时间序列。深度学习模型里常把每个量叫一个通道(channel),一段数据记作 T \times M:T 个时间步,M 个通道。
知识点:什么是遥测?
遥测(telemetry)指设备把自身运行参数远程传回来的数据:卫星的姿态、电压、温度,服务器的 CPU、内存、网络流量。它有个共同特点,正常运行时高度规律,有周期、有缓变的趋势,故障表现为偏离这个规律。所以遥测是异常检测最经典的舞台。
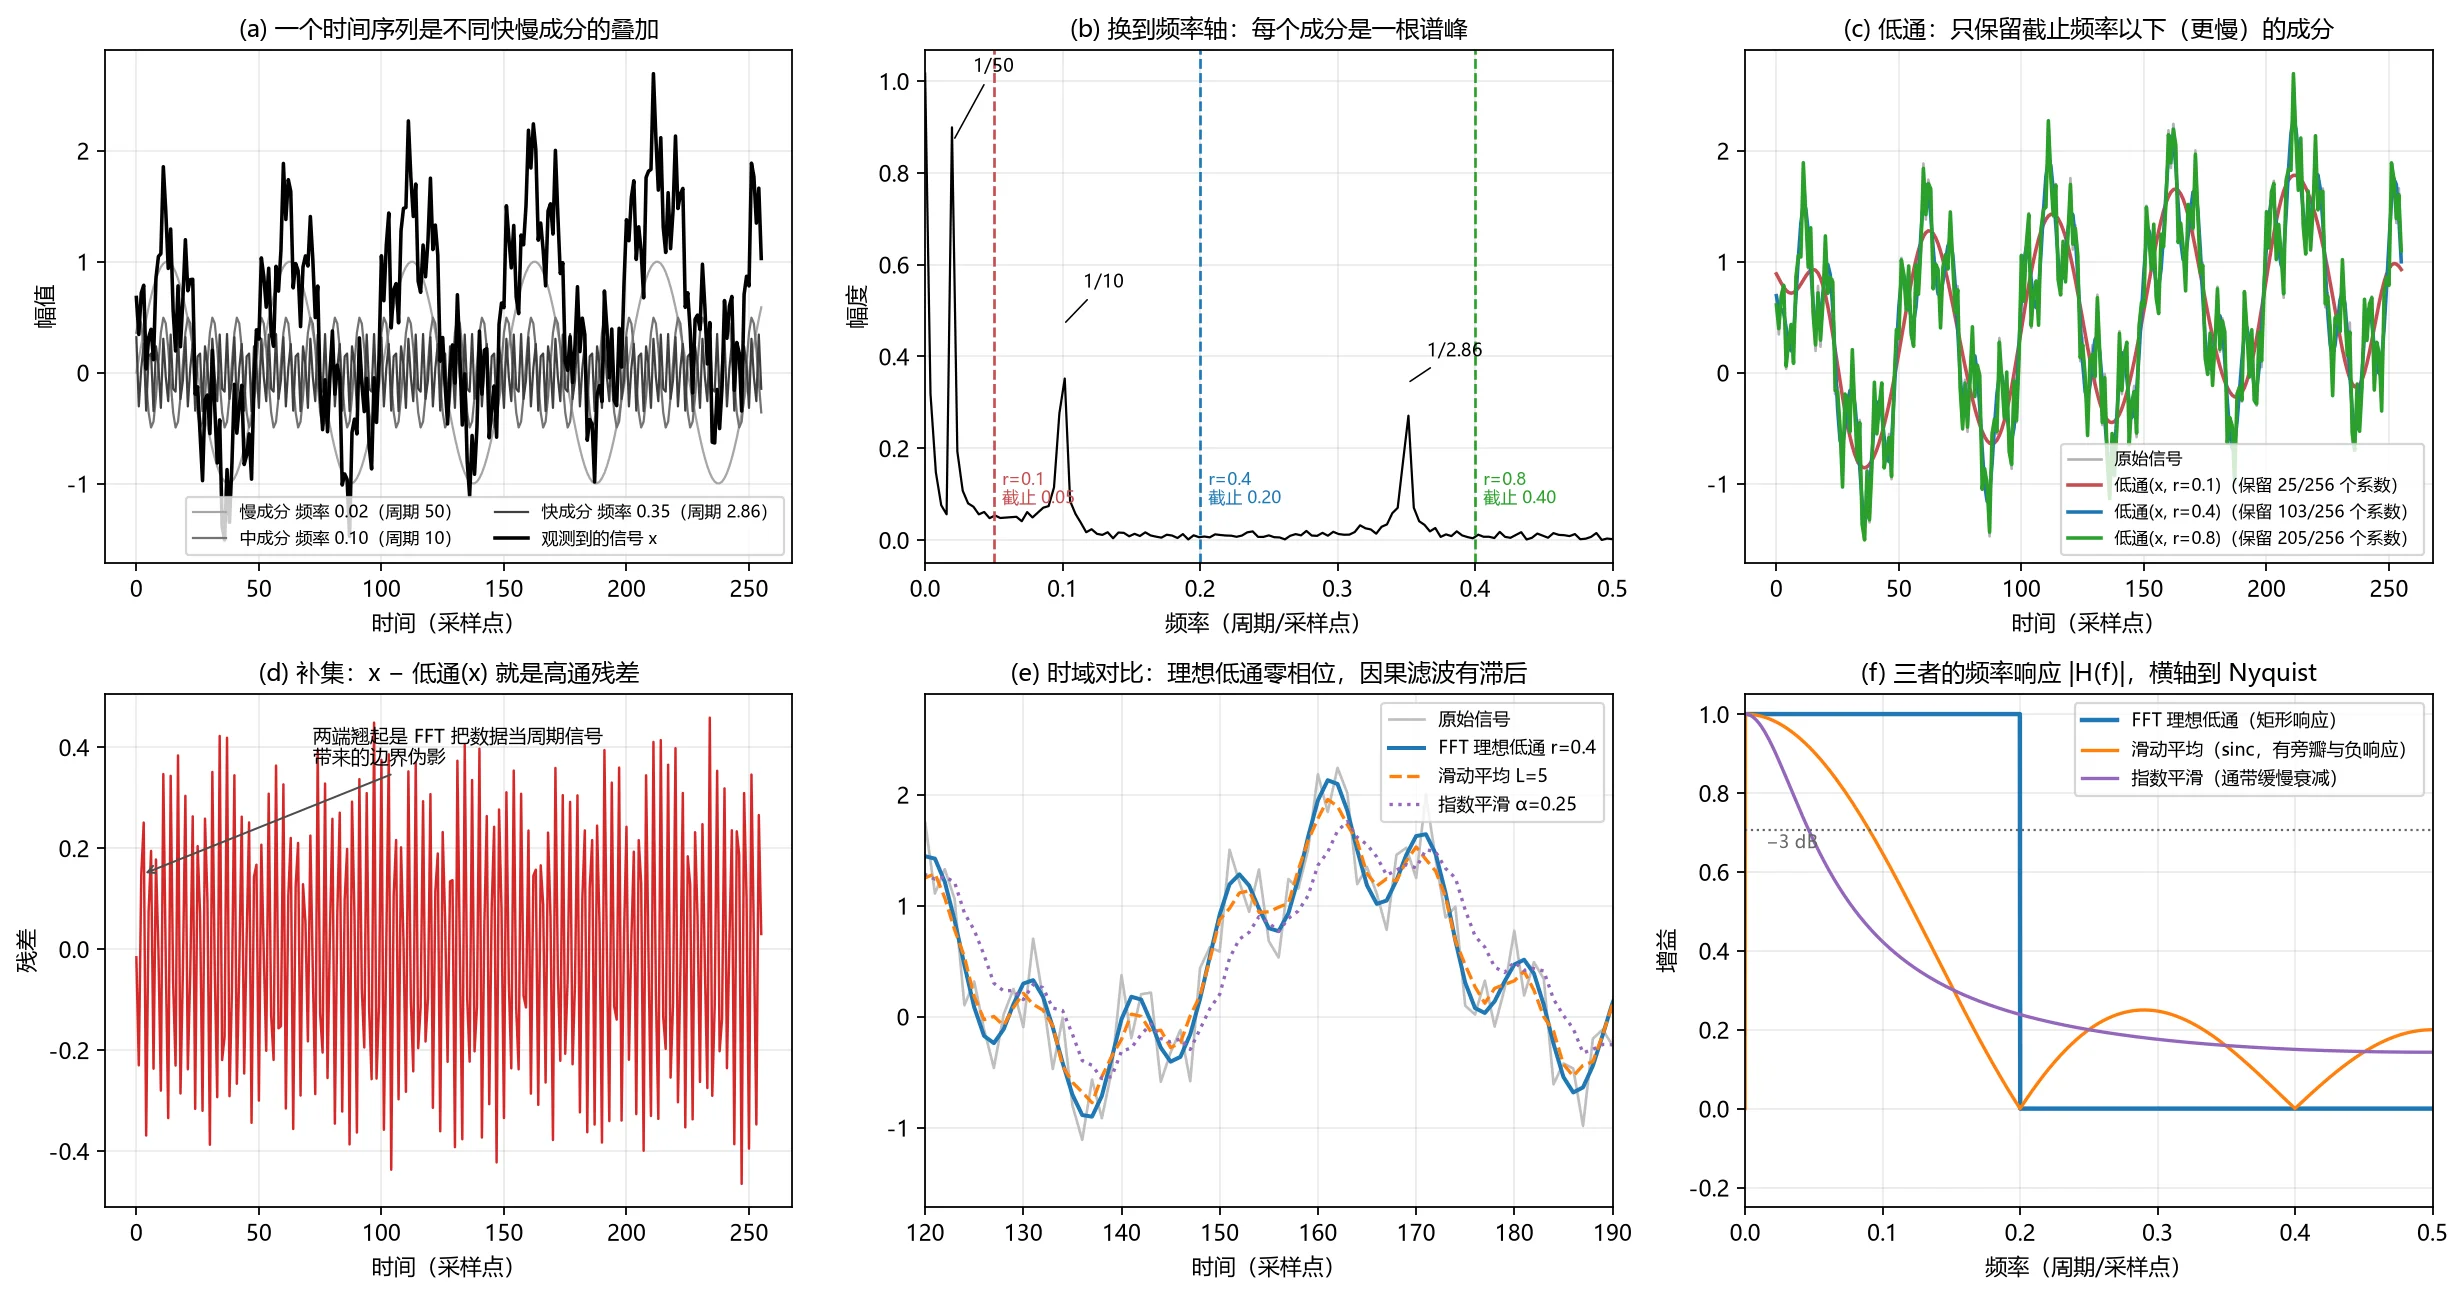
首先,我们看图 1 (a)。一条看起来杂乱无章的曲线,其实是几种起伏的叠加:一个缓慢的大起伏、一个中等快慢的波动、一层很快的抖动,再加一点随机噪声。描述"快慢"的量是频率:
50 个采样点走完一个完整起伏,频率就是 1/50 = 0.02。要换算成真实时间,除以采样间隔 \Delta t:物理频率 = f / \Delta t,周期 = 采样点数 \times \Delta t。如果每分钟采一个点,f = 0.02 对应的就是 50 分钟一级的慢变。
这里有一条硬约束,叫采样定理:采样间隔定下来之后,能表示的最快起伏是两个采样点一个周期,对应频率 0.5,这个上界叫 Nyquist 频率(奈奎斯特频率)。真实世界里比这更快的东西不会消失,而是混叠(aliasing):伪装成某个低频成分留在数据里。生活里最直观的例子是视频里车轮倒转——车轮的真实转速超过了帧率能表示的上限,于是"假装"成一个慢得多的转速。更多细节见下一节。
拓展:为什么异常检测关心"快慢"? 时序异常检测(anomaly detection)的目标是给每个时间点打一个"不正常程度"的分数,而故障按时间尺度分家:瞬时尖峰(毛刺)主要抬高高频;缓慢漂移(性能退化、传感器老化)藏在低频里;周期性异常要跟已知周期对齐才看得出来。按快慢切开不是数学游戏,是先把不同类型的故障分进不同的抽屉。
2.1 采样定理
2.1.1 先把"采样"这件事说清楚
真实世界是连续的,传感器只能每 \Delta t 记一个数。两个采样点之间发生了什么,数据里完全没有记录——采样的全部信息,就是那串整数时刻上的值。混叠的一切麻烦都从这里来:我们不是"看错了"快信号,而是从头到尾就没拿到过能区分它的信息。
2.1.2 为什么下限偏偏是"两个采样点一个周期"
要"看见"一个完整起伏,至少得采到一次波峰、一次波谷,也就是一个周期里至少两个点。周期短于 2\Delta t 的波,在两个采样点之间已经走完了一整圈,采样序列就开始重复自己——这正是"0.5 是上界"的直觉版本(一个周期两个点,频率就是 1/2 = 0.5 周期/采样点)。
两个补充,把这件事说严实:
恰好两个点还会整波失踪。比如 x_n = \cos(2\pi \cdot 0.5 \cdot n + \pi/2) = \cos(\pi n + \pi/2):不管 n 是奇是偶,\cos 的相位都落在 90° 或 270°,取值恒为 0。一个真实存在、幅度不小的波,如果采样时刻恰好都踩在它的过零点上,采出来是一串死零。
0.5 是数学上界,不是工程推荐值。音频 CD 用 44100 Hz 采样,而人耳上限约 20 kHz,比例 2.2 倍——多出来的部分不是浪费,是留给抗混叠滤波器滚降的过渡带;频谱仪常用的经验值是按最高关心频率的 2.56 倍采样。道理相同:贴着 2 倍下限采样,滤波器没有容错空间。
2.1.3 "伪装成低频"的机制:一条一行就能写完的恒等式
在整数采样点上,频率相差任意整数的两个波,取值完全相同:
因为多出来的那一圈 2\pi n 是整数个完整周期,\cos 转回原地。这不是"近似像",是严格相等。
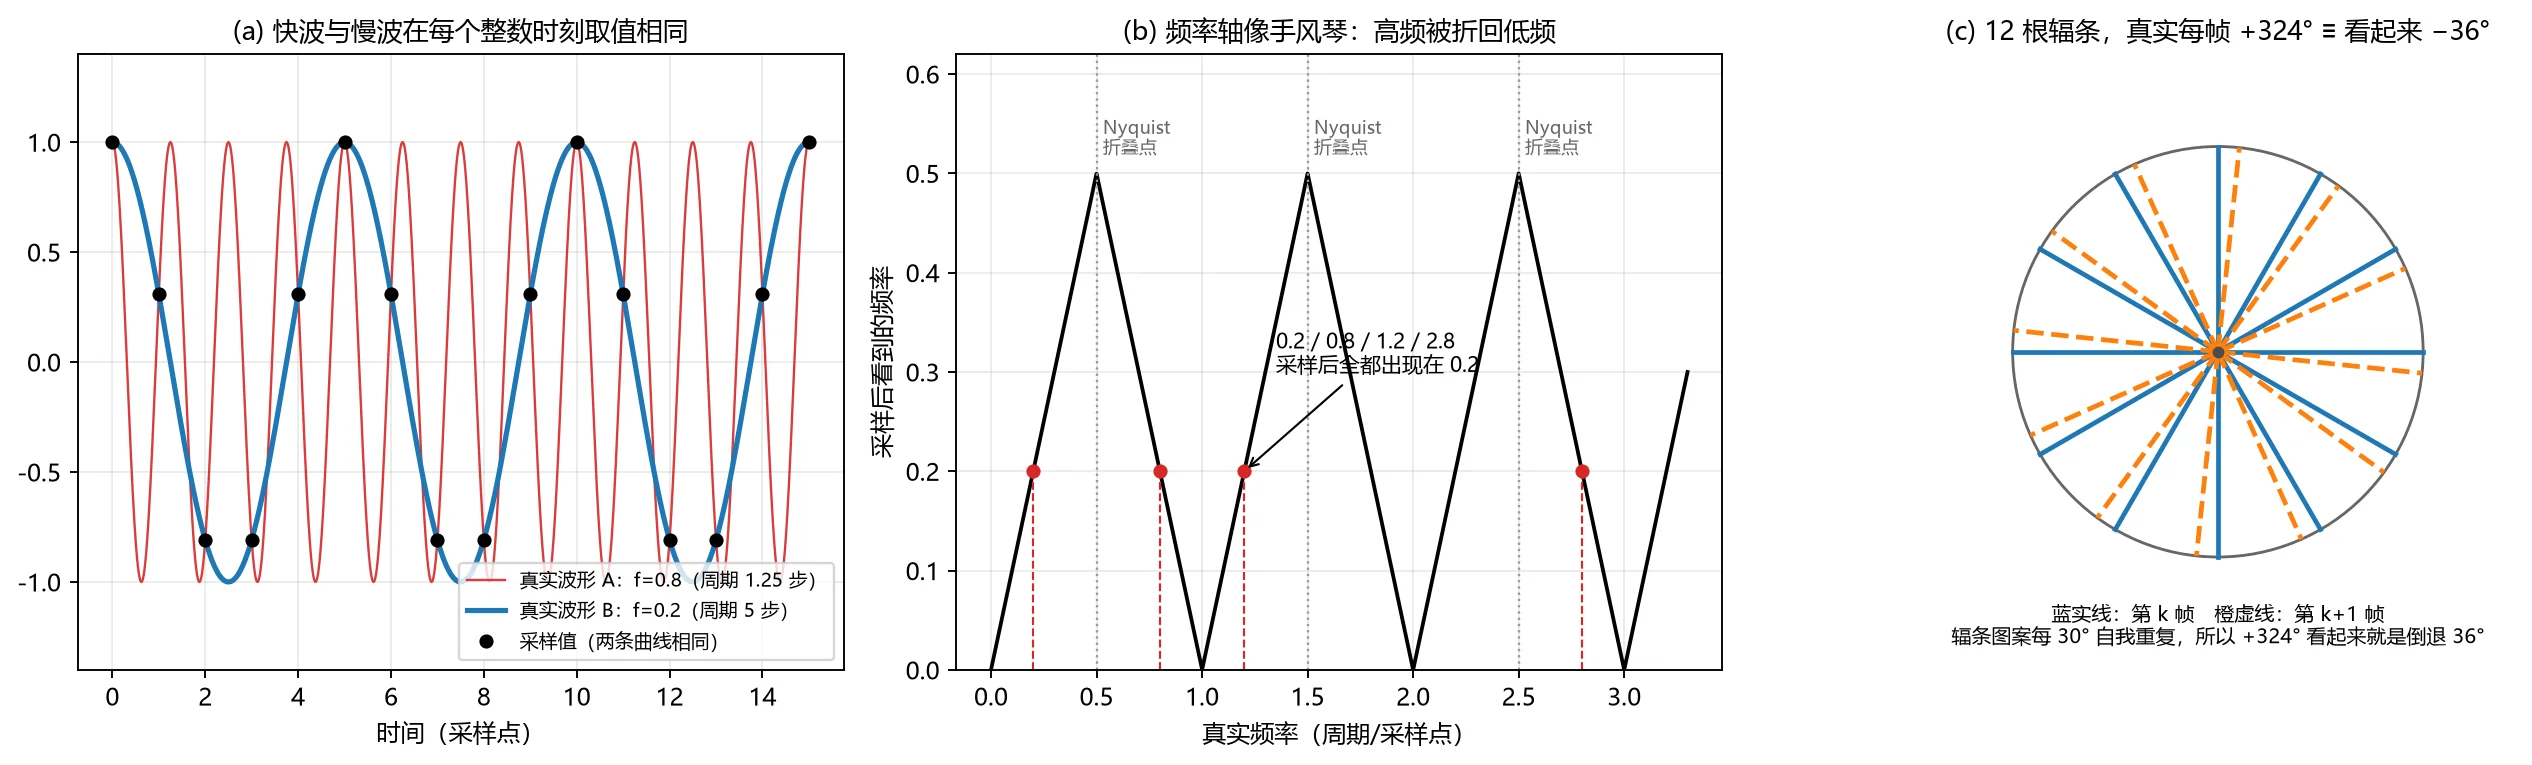
代个数验证(图 2 (a) 画的就是这两条):真实的快波 f = 0.8(周期 1.25 步)和慢波 f = 0.2(周期 5 步),采样序列一模一样:
所以准确的说法是:采样这一步把"到底是 0.8 还是 0.2"这个区别彻底销毁了。不是难以区分,是数据里根本不存在这个区分——事后任何滤波、任何算法都救不回来。这就是为什么"先低通再降采样"是铁律:要在丢点之前,把高于新 Nyquist 的成分消灭掉。
2.1.4 车轮倒转:多出来的那半个信息是"方向"
再看相位。快波 f=0.8 的采样相位(模一个周期)是 0, 0.8, 0.6, 0.4, 0.2——在倒退,每步退 0.2;慢波是 0, 0.2, 0.4, 0.6, 0.8——正着走。\cos 是偶函数,所以两组取值相同,但"倒着走"这个信息还在。对余弦曲线无所谓(实数信号本来就分不出方向),对有方向的图案就是可见的反转。
车轮就是这么倒转的:12 根辐条,图案每 30° 自我重复。假设每帧车轮真实前进 324°(0.9 圈),下一帧的辐条落在 324°, 354°, 24°, \dots,恰好等于原图案整体倒退 36°。于是你"看见"的不是 +324°,而是 −36°(图 2 (c))。带符号的一般规律:看起来在动的量 = 真实频率减去最近的整数,0.9 - 1 = -0.1 圈/帧,负号就是倒转。
2.1.5 折叠:频率轴其实是个手风琴
把上面两条合起来,采样后的"视在频率"是
即真实频率到最近整数的距离。频率轴不是一条直线,而是被 Nyquist 点(0.5, 1.5, 2.5, …)折成手风琴,所有折叠都压进 [0, 0.5] 这一段(图 2 (b)):
更深一层的说法:采样让频谱以 1(周期/采样点)为周期无限复制,频率轴闭合成一个周长为 1 的圆环,FFT 只能看到环上 [0, 0.5] 那一段,其余部分全都叠在里面的某个位置上。"伪装"不是错觉,是圆环上的重叠。
2.1.6 落到实用:怎么怀疑和检查混叠
先算再信。系统里有已知的快源(电机转速、50 Hz 工频及其谐波),先按 \min_k |f - k f_s| 算一遍它们会伪装到哪,再对照谱里的峰。
变采样率检验。真峰钉在物理频率上不动;假峰跟着采样率移动。有条件时提高采样率采一小段对比,是最干净的判据。
没有物理解释的慢振荡要起疑。数据里出现一个"谁也解释不了"的低频摆动,第一反应应该是查它是不是某个快信号的影子——这比把它当成真实趋势去建模安全得多。
3 换到频率轴:FFT 到底做了什么
拓展:变换就是换一组坐标。
学过线性代数的话可以这样理解:傅里叶变换只是换了一组"坐标基"。原来的坐标是"第 n 个采样点上的值",换成了"第 k 个整数周期正弦分量占多少"。信号没变,变的是描述它的语言。好处是有些规律在频率语言里特别省字——"这信号慢悠悠的"在时域要描述整条曲线,在频域只要几个数字。
对长度为 T 的一段数据做离散傅里叶变换(DFT,工程上的快速算法叫 FFT),得到 T 个复数系数:
第 k 个系数对应的频率是
对实数信号,X_{T-k} 与 X_k 互为共轭,一对正负频率携带的是同一份信息,所以独立的实数自由度只有 T/2 + 1 个(T 为偶数时)。画幅度谱时习惯只画 0 到 0.5 这一段(图 1b),或者按有符号的 k 画成左右对称。
为了阅读方便,此处再放一遍图 1
读谱的方法很朴素:峰在哪个频率,序列里就有哪个周期的成分。图 1 (b) 里三根谱峰,正好对应图 1 (a) 里人为放进去的三个成分;没放成分的地方,只剩一条低低的噪声底。
需要澄清一个常见误会:FFT 不是"自动找周期"的魔法。它只是把信号投影到一组固定的正弦基上。峰高会被噪声抬高,会被数据长度截断抹平(第 6 节的谱泄漏),非整数个周期还会让峰变宽。想用 FFT 找周期,得知道这些因素在怎么干扰读数。
4 低通 = 频率轴上的一条掩码
有了频率轴,"低通"就有了最直白的实现:把 k 太靠外(频率太高)的系数直接置零,其余原封不动,再逆变换回时域。这个"切一刀"的滤波器叫理想低通(brick-wall,砖墙):
截止位置 k_c 怎么定?用 Nyquist 的比例 r 来参数化最方便:令 k_c = \lfloor rT/2 \rfloor。Nyquist 对应的指标恰好是 T/2,所以 r 就是"保留到 Nyquist 的几分之几",截止频率 f_c = r \times 0.5,能通过的最短周期为
这个参数化还有两个值得记住的副产品:
投影视角。保留 2k_c + 1 根谱线,等价于把信号投影到一个低维子空间,r 越小投影掉的维度越多。这解释了低通结果为什么总是"变简单了":它的自由度真的变少了。
直流分量就是均值。k = 0 的系数除以 T 正是这段数据的平均值,而 k = 0 永远被保留。所以低通结果不是零均值的,做差、做残差的时候要记得这一点。
十行实现(第 7 节还会用到它):
import numpy as np

def lowpass(x, r):
    """理想低通:保留 |k| <= r*T/2 的傅里叶系数,其余置零。"""
    T = len(x)
    k = np.round(np.fft.fftfreq(T) * T).astype(int)  # 有符号指标: 0..T/2-1, -T/2..-1
    mask = np.abs(k) <= int(np.floor(r * T / 2))
    return np.real(np.fft.ifft(np.fft.fft(x) * mask))
np.fft.fftfreq(T) * T 给出的正是有符号的 k(先正后负),取绝对值加掩码就是上面的 H。图 1 (c) 是同一信号在三个 r 下的结果:r = 0.1 只剩最慢的一层,r = 0.4 保住中等波动,r = 0.8 连很快的抖动都留下了。
5 时域做法,以及两种做法怎么选
不在频率轴上切,也可以直接在时域做"加权平均":
h_\tau 是一组权重。滑动平均(moving average)取 h_\tau = 1/L,L 个点取平均;指数平滑(exponential smoothing)写成递推 y_t = (1-\alpha) y_{t-1} + \alpha x_t,越旧的点权重按指数衰减。
卷积定理把两种做法接到一起:时域卷积等价于频域相乘,Y_k = H_k X_k。也就是说,任何一个时域滤波器都有一条频率响应曲线 |H(f)|,决定每个频率被保留多少。三种常用滤波器的响应画在图 1 (f):
FFT 理想低通:矩形,截止之前全过、之后全挡,边界锐利;
滑动平均:sinc 形,截止之后还会反复冒头,甚至有一段是负的——某些中频成分不但没被压掉,还被反相叠加了;
指数平滑:没有明确的截止点,通带里就已经在缓慢衰减。
时域做法还有一个频域做法没有的问题:相位滞后。指数平滑只能用"过去"推"现在",天生慢半拍,对一个斜坡输入的稳态滞后约为 (1-\alpha)/\alpha 个采样点,图 1 (e) 里紫色曲线整体右移就是它。滑动平均如果居中取窗(用到未来的点)可以做到零相位,但那就不是在线算法了;因果取窗则滞后半个窗长。
一句话选型:离线、要精确的频带控制,用 FFT 掩码;在线、能容忍一点滞后,用指数平滑;出图做展示,用居中滑动平均。
6 低通与高通在时序分析里的四个用途
先补一个定义:高通就是补集。y_{\mathrm{HP}} = x - \mathrm{LP}(x),把低频拿掉,剩下的自然全是高频;带通则是在频率轴上开一个窗口,两头都切。
用途一:平滑与去趋势,为了"看得清"。 展示数据时把高频抖掉,趋势和周期才不会被淹没。这是最低配的用法,也最容易让人误以为"平滑 = 分析"。它只改观感,不添信息。
用途二:残差即高通,找异常的经典思路。 把"规律的部分"(趋势 + 周期)用低通或分解拿掉,剩下的残差里就是"不规律的部分":突变、尖峰、断裂。
拓展:STL 分解。
STL(Seasonal-Trend decomposition using Loess,Cleveland 等,1990)把一条序列拆成三部分:趋势(慢变)+ 季节(固定周期)+ 残差(剩下的)。它是"趋势—季节—残差"三分法的标准实现,很多时序工具都内置了。残差项天然就是一条"去规律化"的高通信号。
拓展:无监督异常检测的两条经典路线。
故障罕见且标注昂贵,训练数据里几乎全是正常样本,所以主流方法是无监督的:先从正常数据里学"正常长什么样"。预测式模型用历史预测下一步,预测误差大就是异常;重构式模型把输入压缩再还原,还原误差大就是异常。两条路线的打分最终都落在残差上,所以"在高通残差里找异常"是整个领域反复出现的母题。NASA 的遥测工作(Hundman 等,KDD 2018)用 LSTM 预测加动态阈值,是这个思路的著名公开实例。
用途三:多尺度分析。 一次低通只给一个尺度;要"同时看好几档快慢",标准工具是小波变换(wavelet):用一族可伸缩、可平移的短波在不同尺度上分别与信号匹配,得到"哪个时刻、哪个快慢"有能量,兼顾时间和频率定位。比单一砖墙低通信息丰富,代价是概念和实现都更重。
用途四:把频域搬进模型当表征。 近年不少已发表工作把频率操作做进网络里:TimesNet(ICLR 2023)用 FFT 找出主周期,把一维序列按周期折叠成二维("周期内 × 周期间"),用 2D 卷积分别建模;FEDformer(ICML 2022)在傅里叶域做稀疏注意力,只保留最显著的少数频率分量;CATCH(ICLR 2025)把频谱切成若干频带分块处理,在不同频带里分别建模多变量之间的通道关系。它们共同的直觉是:很多时序规律在频率语言里更省参数。
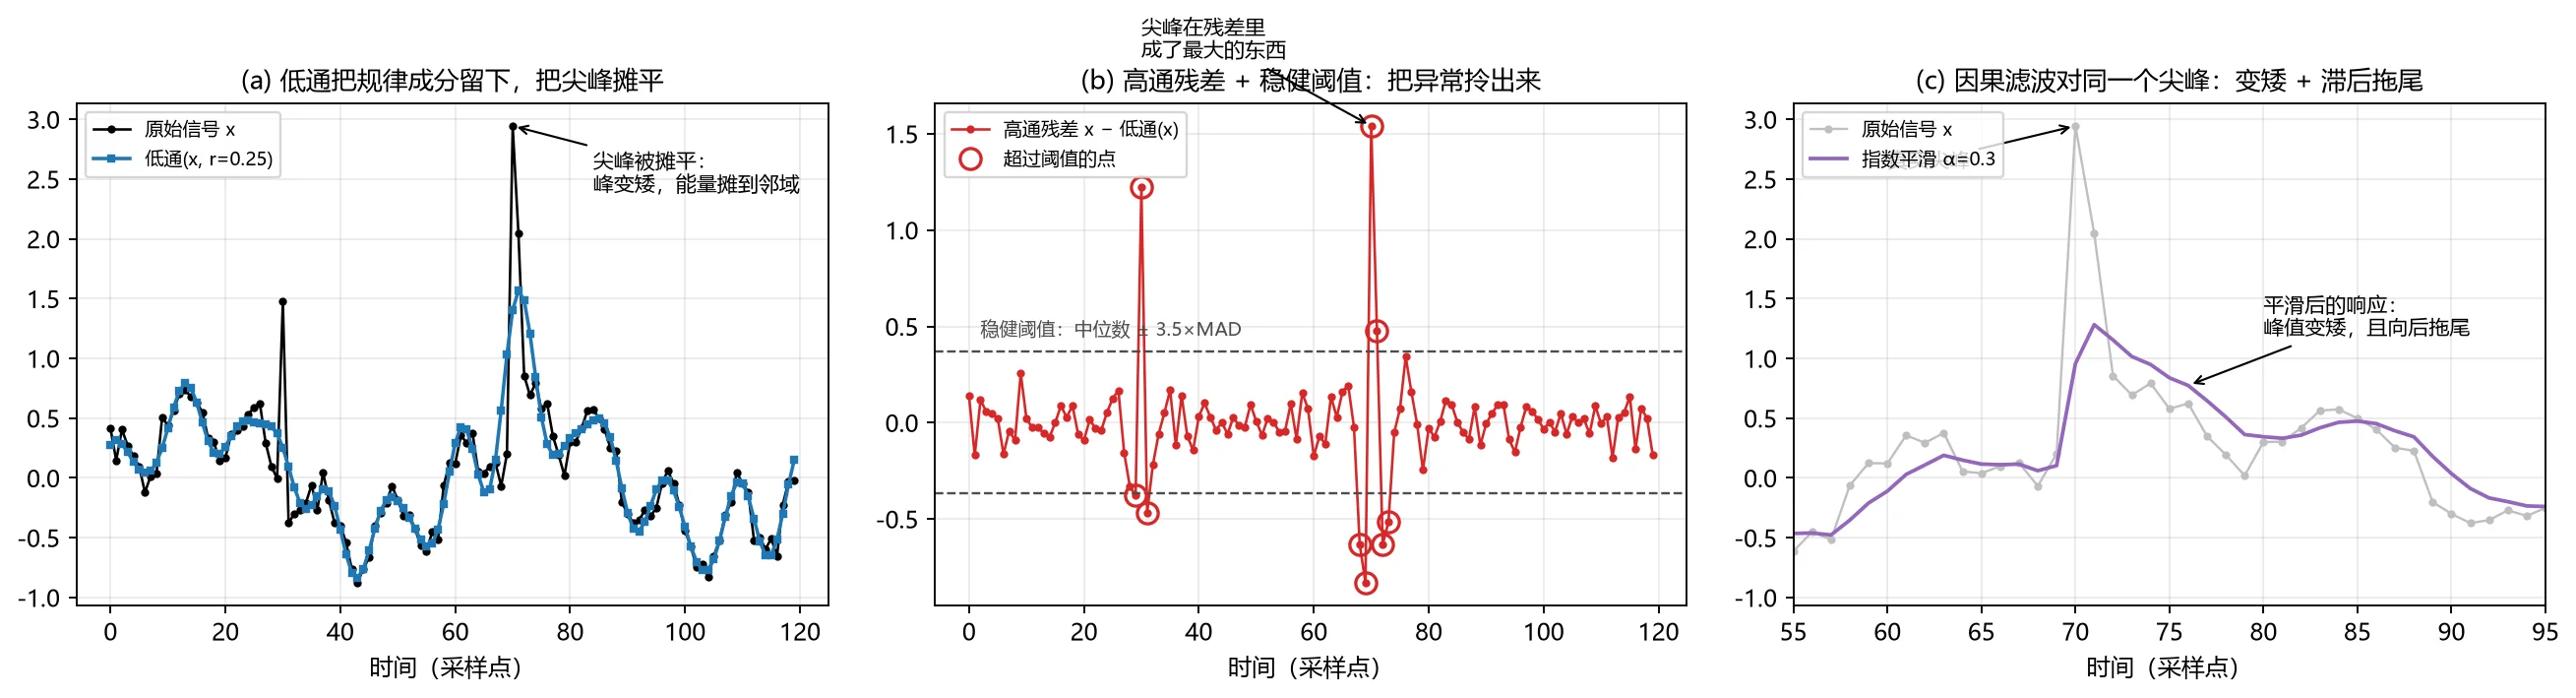
图 3 把用途二演给你看。图 3 (a) 里,低通把两条周期成分完整留下,但把尖峰摊平成一个矮胖的鼓包;图 3 (b) 里,残差把尖峰原样拎了出来,超过稳健阈值的点(圆圈标出)正好聚在注入异常的地方,两侧的负瓣是砖墙滤波的振铃;图 3 (c) 则说明如果换成因果的指数平滑,尖峰不但变矮,还会向后拖出一段尾巴。
7 六个容易踩的坑
坑 1:循环边界伪影。 FFT 隐含假设这段数据是某个无限周期信号的截断,即首尾能无缝接上。真实数据两端几乎必然对不齐,这个"接缝"是人为制造的不连续点,逆变换后会在两端产生振荡——图 1 (d) 两端翘起的部分就是它,本质是 Gibbs 现象。缓解办法:先去趋势再做 FFT;或做镜像延拓(把序列首尾翻转拼出去,处理完再截回来);或接受它,只在远离边界的区域做判断。
坑 2:低通 ≠ 去噪。 对持续的高频抖动,低通确实能压。但对脉冲型的尖峰,低通是把它的能量摊到邻近若干点上——峰变矮了,能量还在(图 3a)。而故障在遥测里经常就是尖峰。要对脉冲鲁棒,标准工具是中值滤波(取邻域中位数,单个极端值对中位数几乎无影响),而不是低通。
坑 3:归一化顺序与采样间隔。 多变量数据各通道量纲差异巨大(温度几十度、电压几伏、流量几千),通常先做 per-channel z-score:每个通道减自己的均值、除以自己的标准差,变成均值 0、方差 1。Z-score 和低通都是线性操作,先后顺序在数学上可交换;但截止频率的物理含义只跟采样间隔挂钩:同样 r = 0.4,每分钟采样的数据里"周期 5 步"是 5 分钟,每秒采样就是 5 秒。跨数据集比较时,先问采样间隔,再谈 r 合不合理。
坑 4:误差尺度随窗口和通道数增长。 如果把低通结果放进某个损失项里,注意范数的量级:求和型范数(如 Frobenius 范数 \lVert \cdot \rVert_F^2,即对矩阵全部元素平方求和)对 T \times M 个元素求和,窗口越长、通道越多数值越大,固定权重的正则项相对就变弱。要跨规模可比,用均值(除以元素个数)而不是求和。
坑 5:混叠。 第 1 节说过,超过 Nyquist 的真实频率会伪装成低频留在数据里,而且事后无法分离。所以降采样之前必须先低通(抗混叠滤波),这是信号处理里铁律级别的顺序。拿到一份来历不明的数据时,"里面有没有混叠"值得先问一句。
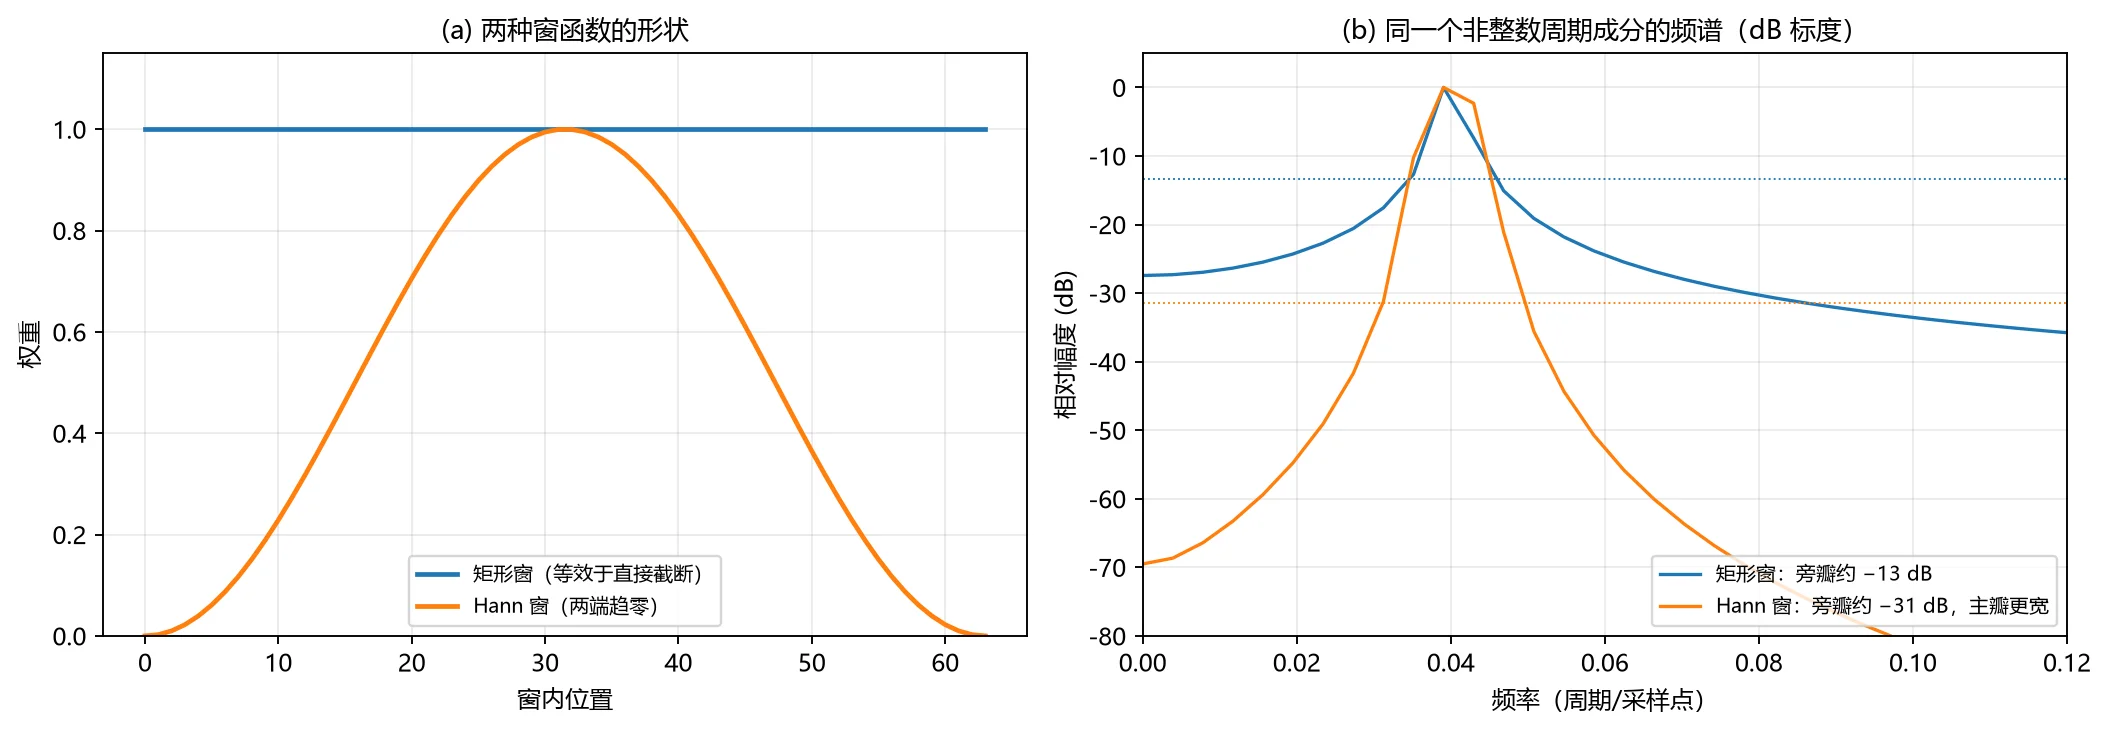
坑 6:谱泄漏与窗函数。 "峰在哪个频率就是哪个周期"有个前提:信号的周期恰好是数据长度的整数分之一。如果不是——比如 256 点的数据里藏着一个周期 24.85 点的成分——截断本身会把这根谱峰的能量"泼"到旁边的频率上,主峰变宽、两侧出现一串旁瓣,这叫谱泄漏(spectral leakage)。标准缓解办法是加窗:变换前给数据乘一个两端趋零的窗函数(如 Hann 窗),把接缝抹平,代价是主瓣变宽、相邻两个频率更难分开。图 4 是同一根非整数周期谱峰在两种窗下的对比:旁瓣从约 -13 dB 降到约 -31 dB,主瓣宽了一倍。"要不要加窗",就是在"在乎旁瓣"和"在乎分辨率"之间做取舍。
8 一个例子
把前面所有东西串起来:合成一段带尖峰的数据,低通拿走规律成分,高通残差里用稳健阈值把注入的异常找回来。
import numpy as np

def lowpass(x, r):
    """理想低通:保留 |k| <= r*T/2 的傅里叶系数,其余置零。"""
    T = len(x)
    k = np.round(np.fft.fftfreq(T) * T).astype(int)
    return np.real(np.fft.ifft(np.fft.fft(x) * (np.abs(k) <= int(np.floor(r * T / 2)))))

def to_intervals(idx):
    """把相邻的检出点合并成区间 [起, 止)。"""
    if len(idx) == 0:
        return []
    cuts = np.where(np.diff(idx) > 1)[0]
    return [(int(a), int(b) + 1) for a, b in
            zip(np.r_[idx[0], idx[cuts + 1]], np.r_[idx[cuts], idx[-1]])]

rng = np.random.default_rng(0)
t = np.arange(300)
x = 0.6*np.sin(2*np.pi*t/50) + 0.4*np.sin(2*np.pi*t/12) + 0.05*rng.standard_normal(300)
x[80:83] += 2.2                                   # 注入一段 3 步的尖峰异常
x[205:208] += 2.2                                 # 再注入一段

res = x - lowpass(x, r=0.6)                       # 截止周期 2/r ≈ 3.3 步:周期成分全过,尖峰进残差
med = np.median(res)
mad = np.median(np.abs(res - med)) * 1.4826       # MAD,1.4826 对齐高斯标准差
flag = np.where(np.abs(res - med) > 3.5 * mad)[0]

print("注入的异常区间:", to_intervals(np.array([80, 81, 82, 205, 206, 207])))
print("检出的异常区间:", to_intervals(flag))
实际输出:
注入的异常区间: [(80, 83), (205, 208)]
检出的异常区间: [(79, 85), (203, 210)]
拓展:为什么用 MAD 而不是均值 ± 3σ?
MAD(median absolute deviation,中位绝对偏差)先取残差的中位数,再取"每个点到中位数距离"的中位数。中位数对少数极端值几乎无动于衷,所以残差里混着异常点时,MAD 仍能稳定估计"正常波动有多大";系数 1.4826 让它对高斯噪声与标准差对齐。反过来,均值和标准差会被异常点自己撑大——异常越严重阈值越高,越检不出来,这在检测任务里是不可接受的失效方向。
三点小注意点:
为什么 r = 0.6? 两条周期成分(周期 50 和 12)要完整留在低通里,截止周期 2/r \approx 3.3 步足够低;尖峰只有 2–3 步宽,正好落进残差。r 的选择本质上是"我认为什么算规律"这句话的数学版本。
检出区间比注入区间宽 1–2 个采样点。 这不是 bug,而是图 3 (a) 那个"摊平"效应的直接后果:砖墙滤波把尖峰的能量摊到邻域,阈值把振铃的肩膀也标了进来。实际系统通常会对残差再平滑一次、或把相邻检出点合并成区间,点级评价对这类方法天然偏严。
能检出尖峰,靠的不是低通"消除"了它们,而是低通把规律成分拿走之后,尖峰成了残差里剩下的主要东西。这就是用途二的完整逻辑。
9 延伸阅读
延伸阅读:
Steven W. Smith, The Scientist and Engineer's Guide to Digital Signal Processing,全文免费(dspguide.com),写法比教材亲切得多,滤波器与窗函数恰好在第 18–21 章;
Oppenheim & Willsky, Signals and Systems,想要系统版去啃这本;
Cleveland et al., 1990, STL: A Seasonal-Trend Decomposition Procedure Based on Loess, Journal of Official Statistics;
TimesNet(ICLR 2023)、FEDformer(ICML 2022)、CATCH(ICLR 2025),把频率操作做进深度模型的三种不同方式;
Hundman et al., 2018, Detecting Spacecraft Anomalies Using LSTMs and Nonparametric Dynamic Thresholding(KDD),遥测异常检测加残差打分的经典公开工作。
10 写在最后
笔者在后续科研进程中,可能会涉及到时序相关的知识点,奈何对该领域实在不熟悉。虽借助 AI 整理了一篇博客,略窥得此领域大概,但罗马不是一天建成的,还有很多要学。另最近琐事缠身实是没空,后续还是得找一些书籍或课程耐心看看。
诸位读者若看到此处有推荐的书籍 or 课程,不妨在下方评论区留言赐教,不胜感激。