服务网格入门:边车、mTLS 与链路追踪
1 前言
此文详细拓展了微服务架构文中提及的“服务网格”概念。
2 什么是“服务网格”
服务网格,就是把“服务间通信”这件事,从每个服务的业务代码里搬出来,交给一层专门的基础设施统一做。
2.1 解决了什么痛点?
微服务拆分之后,A 调 B 这一次网络请求,业务开发者被迫考虑一堆跟业务毫无关系的事:
超时设多少?重试几次?重试会不会重复下单?
B 有 5 个实例,选哪个?B 挂了怎么知道?
B 全线超时了,我还要不要继续把请求打过去?
A 怎么确认“对面真的是 B”,而不是别人冒充的?
B 怎么控制“A 只能查订单、不能退款”?
出问题了,这一串调用到底卡在哪一跳?
如果让每个团队自己在每个服务里实现一遍,结果是:100 个服务里有 100 套风格不同、质量参差的实现,而且换语言要重写。这就是典型的横切关注点(cross-cutting concern)——它切穿了所有业务模块,却不属于任何业务模块。
服务网格的思路是:抽出来,统一做。 类似面向切面编程(AOP)的思想,只是切面在进程外的网络层。
2.2 实现方式
具体怎么“抽”?用边车(sidecar)模式。
“边车”这个词来自摩托车的挎斗:主车往哪走,挎斗跟着往哪走,但挎斗自己装货、自己干活,跟主车是分离的。
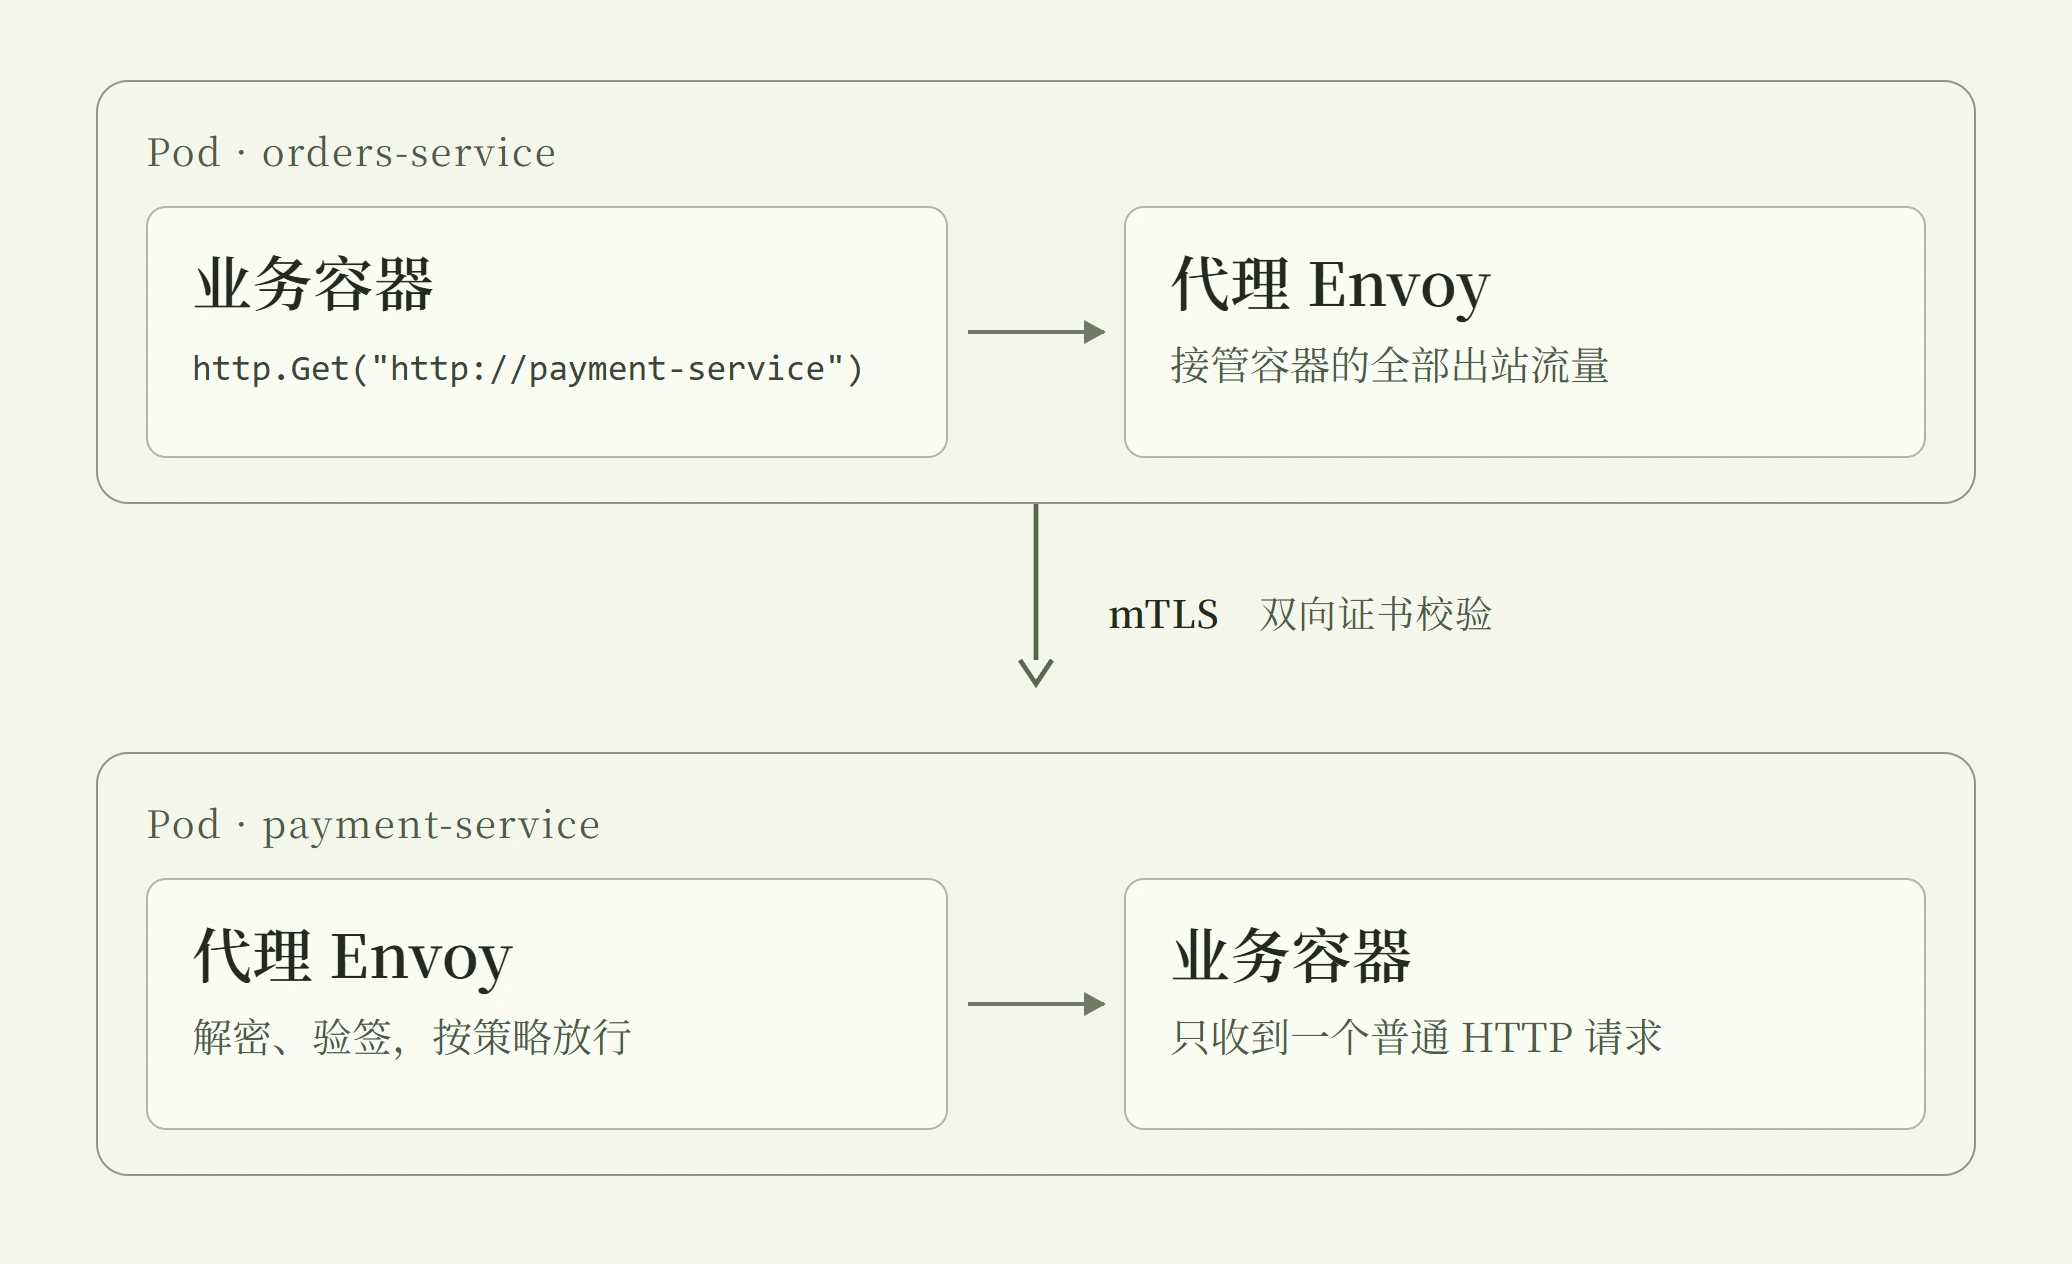
关键点:业务容器自己的网络被“劫持”了——它发出的所有请求,实际上都先交给同 Pod 里的代理,由代理去完成真正的网络通信。所以:
业务代码完全无感:它还是写
http.Get("http://orders-service/..."),以为在直连;治理逻辑全在代理里:重试、超时、熔断、加密、鉴权、埋点,都在代理实现;
换语言不用重写:Java、Go、Python 的服务,享受同一套治理,因为治理不在语言里。
2.3 架构上还分两层
Istio 这类实现把系统分成两个平面:
数据平面(data plane):那些边车代理,负责真正转发流量、执行策略。
控制平面(control plane):一个中央组件,负责下发配置——“A 只能调 B 的 /orders 接口”“mTLS 今天开始强制”“把 5% 流量切到新版本”。它不碰业务流量。
这是很经典的“控制与转发分离”设计。
2.4 顺便区分一个常见混淆
两者互补,不是替代关系。实际部署里常常是“网关处理入口,网格处理内部”。
3 “服务间通信”的治理
3.1 服务发现(Service Discovery)
问题:A 要调 B,可 B 的实例是动态的——今天 3 个 Pod,明天扩到 20 个,IP 每次重启都变。A 怎么知道该发给谁?
做法:引入一个“电话簿”。实例启动时去注册,下线时注销;调用方查一下就知道当前有哪些可用实例。
在 Kubernetes 里,这件事部分由 Service 对象 + DNS 名称 承担(
orders-service.default.svc.cluster.local);服务网格的代理接管后,还会做本地负载均衡(自己选实例)、健康检查(谁不响了就踢掉)。
3.2 重试(Retry)
网络请求会因瞬时抖动失败。重试就是失败后自动再发一次。
虽然这是一个很简单的概念,但实际是分布式系统里最容易出事的机制之一:
重试放大:A 重试 3 次 × B 重试 3 次 × C 重试 3 次 = 一次用户请求放大成 27 次后端调用,本来只是 B 有点慢,结果被重试打成雪崩;
幂等问题:重试一次“扣款”请求,会不会扣两次?所以只有幂等操作(比如查询、
PUT设置)适合无脑重试;重试风暴:所有客户端同时重试,正好在故障恢复的第 0.1 秒把服务再压垮。
服务网格让这些策略可以集中配置(比如“最多重试 2 次,且只在 5xx 时重试,且每请求总预算不超过 1 秒”),而不用每个团队自己发挥。这就叫 retry budget(重试预算)。
3.3 熔断(Circuit Breaking)
问题:如果 B 已经彻底挂了,A 还傻傻地把请求一个个发过去等超时,会怎样?
每个请求都占着 A 的一个连接和一个工作线程,等 30 秒超时;
A 自己的线程池被这些“等待中的请求”占满;
A 对上游 C 也不再响应 → C 也挂了;
于是故障像多米诺一样沿调用链向上传播,这就是 级联故障(cascading failure)。
价值不只在节省资源,更在于故障隔离:B 挂了不该拖死 A,A 还能继续处理不依赖 B 的业务。
顺带一提:还有配套的限流和隔离舱(bulkhead,每个依赖用独立线程池),思路都是“把故障关在盒子里”。此处若是读者感兴趣可以去自行了解。
3.4 双向 TLS 身份认证(mTLS)
先分清两个层次:
普通 TLS(单向):只有服务器出示证书,客户端验证服务器。你在浏览器访问 HTTPS 就是这种——你(客户端)不需要证书。所以普通 TLS 解决的是“服务器是真的”,不解决“客户端是谁”。
双向 TLS(mutual TLS, mTLS):双方都出示证书,双方都验证对方。
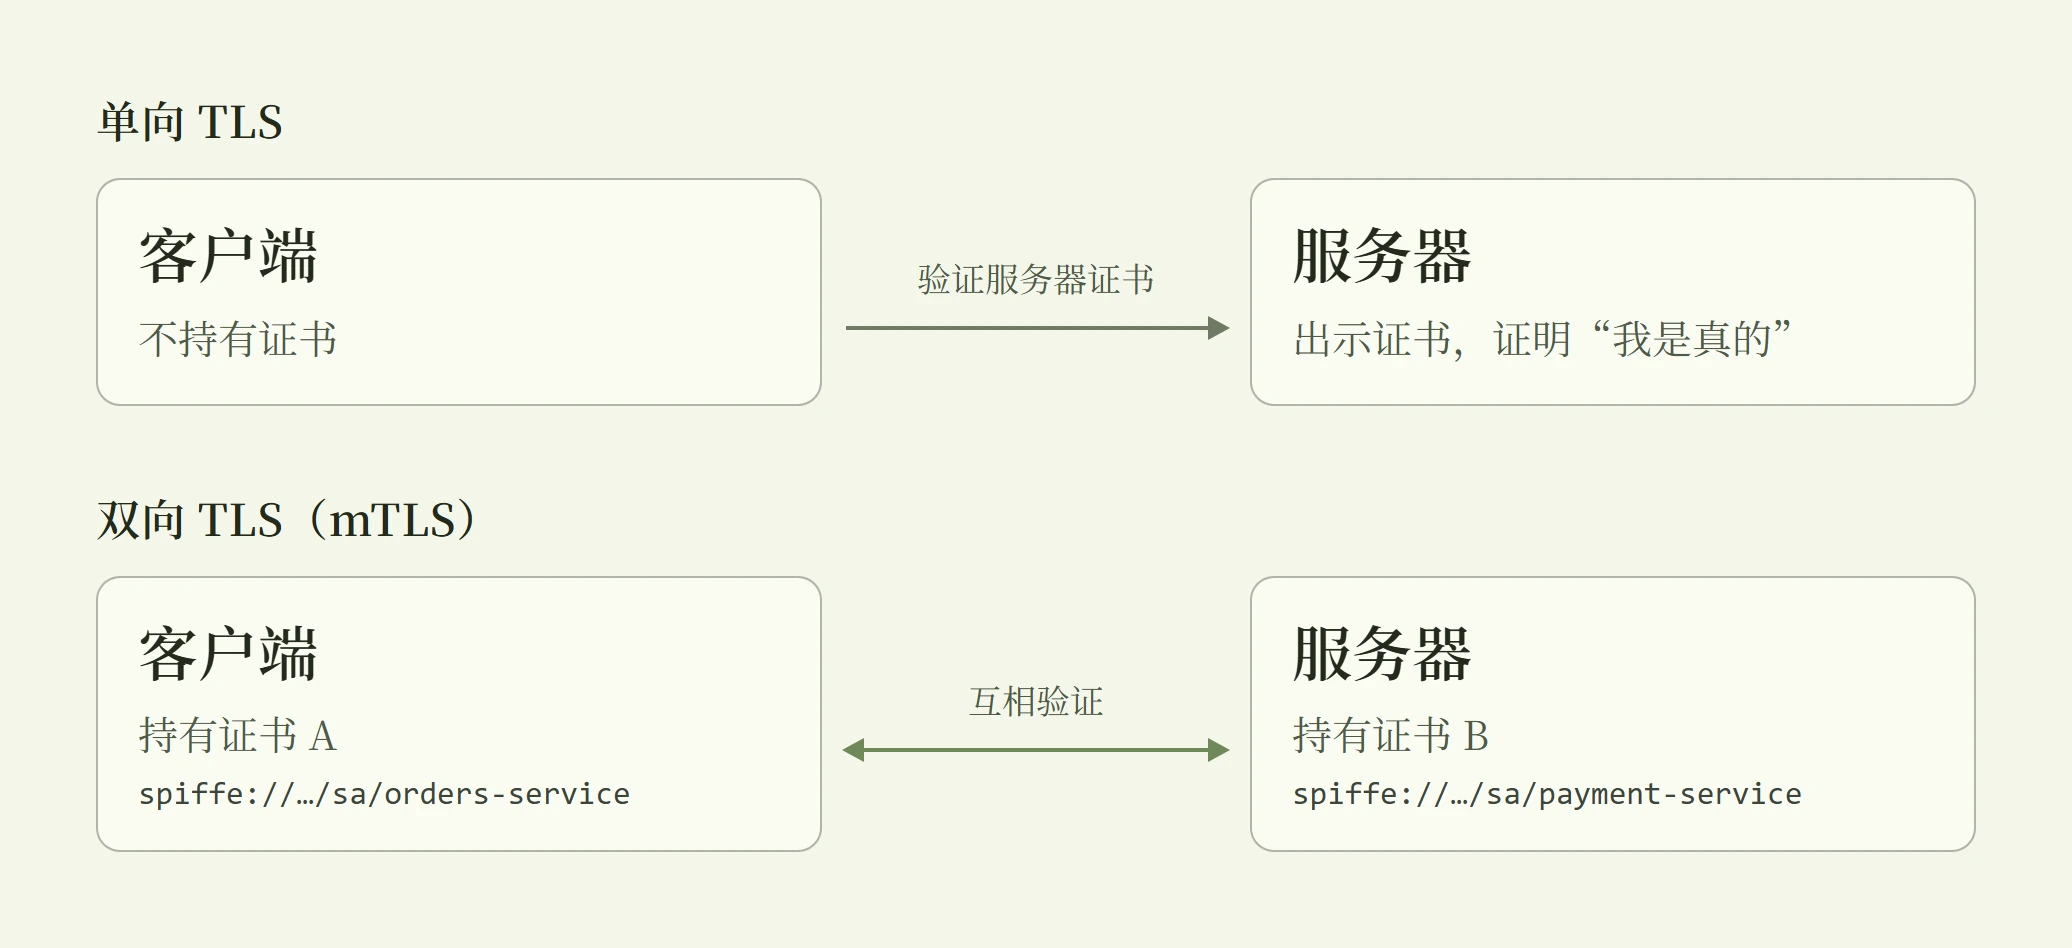
为什么微服务必须要这个?
因为“内部网络”根本不可信:
攻击者一旦攻陷任何一个服务,他人就在“内部”了——如果内部通信只靠“你在内网所以信你”,那他就畅通无阻;
IP 地址不是身份。同一个 IP 今天可能是订单服务,明天可能是攻击者的 Pod(尤其在可被抢占的云环境);
大量服务的通信是服务到服务,没有“用户”这个第三方来充当验证者,没有浏览器帮忙验证书——所以双方必须互证。
具体怎么发证书:
服务网格一般不用传统 CA 那套“一年有效期、人工签发”的流程(笔者注:现在已经没有一年有效期的证书了,悲),而是:
给每个工作负载一个可验证身份,标准叫 SPIFFE ID,长得像一个 URI:
spiffe://cluster.local/ns/default/sa/orders-service;由 SPIRE 之类的签发组件(或 Istio 内置的 Citadel)签发短期证书——有效期常常只有几小时到 24 小时;
证书快到期时自动轮换,代理透明处理,业务代码不感知。
为什么不发长期证书?因为长期证书的核心难题就是吊销。短有效期把“撤销”问题换成了“等它自己过期”,这是一个非常实用的工程取舍,代价是必须有一套可靠的自动轮换机制,而且对时钟同步敏感。
3.5 细粒度授权(Fine-Grained Authorization)
认证(authentication)回答“你是谁”,授权(authorization)回答“你能做什么”。
粗粒度:网络层只允许 A 能连 B 的 8080 端口。但 B 可能有 50 个接口,退款接口和查询接口同样在 8080 上。
细粒度:按方法 + 路径 + 身份控制,比如:
# 概念示意
- from: orders-service          # 身份(SPIFFE ID)
  to:   payment-service
  allow: [ "POST /refund" ]      # 只有这一个接口
- from: report-service
  to:   payment-service
  allow: [ "GET /transactions" ] # 只能只读
关键优势是:策略写在“身份”上,而不是 IP 上。 因为前面有了 mTLS 提供的强身份,授权才能表达“谁能做什么”,而不是“哪个 IP 能做什么”——后者在动态调度环境里会被重启、漂移、IP 复用彻底搞乱。这也正是零信任(Zero Trust)的落地形态:不因为你在内网就信任你,每次通信都要证明身份、检查权限。
3.6 链路追踪(Distributed Tracing)
问题:用户点一次“下单”,背后经过了网关 → 订单 → 库存 → 支付 → 风控 → 通知,6 个服务、十几跳。用户反馈“下单很慢”,你怎么知道卡在哪一跳?
传统日志做不到——每个服务各写各的日志,你没法把它们拼成一条因果链。
做法:给每个请求发一个全局唯一的 trace ID,随请求头在服务间一路传下去;每经过一个服务就记一个 span(“谁、什么时候开始、多久结束、父 span 是谁”)。所有 span 汇总到后端(Jaeger、Tempo、Zipkin),就能画出完整的调用树:
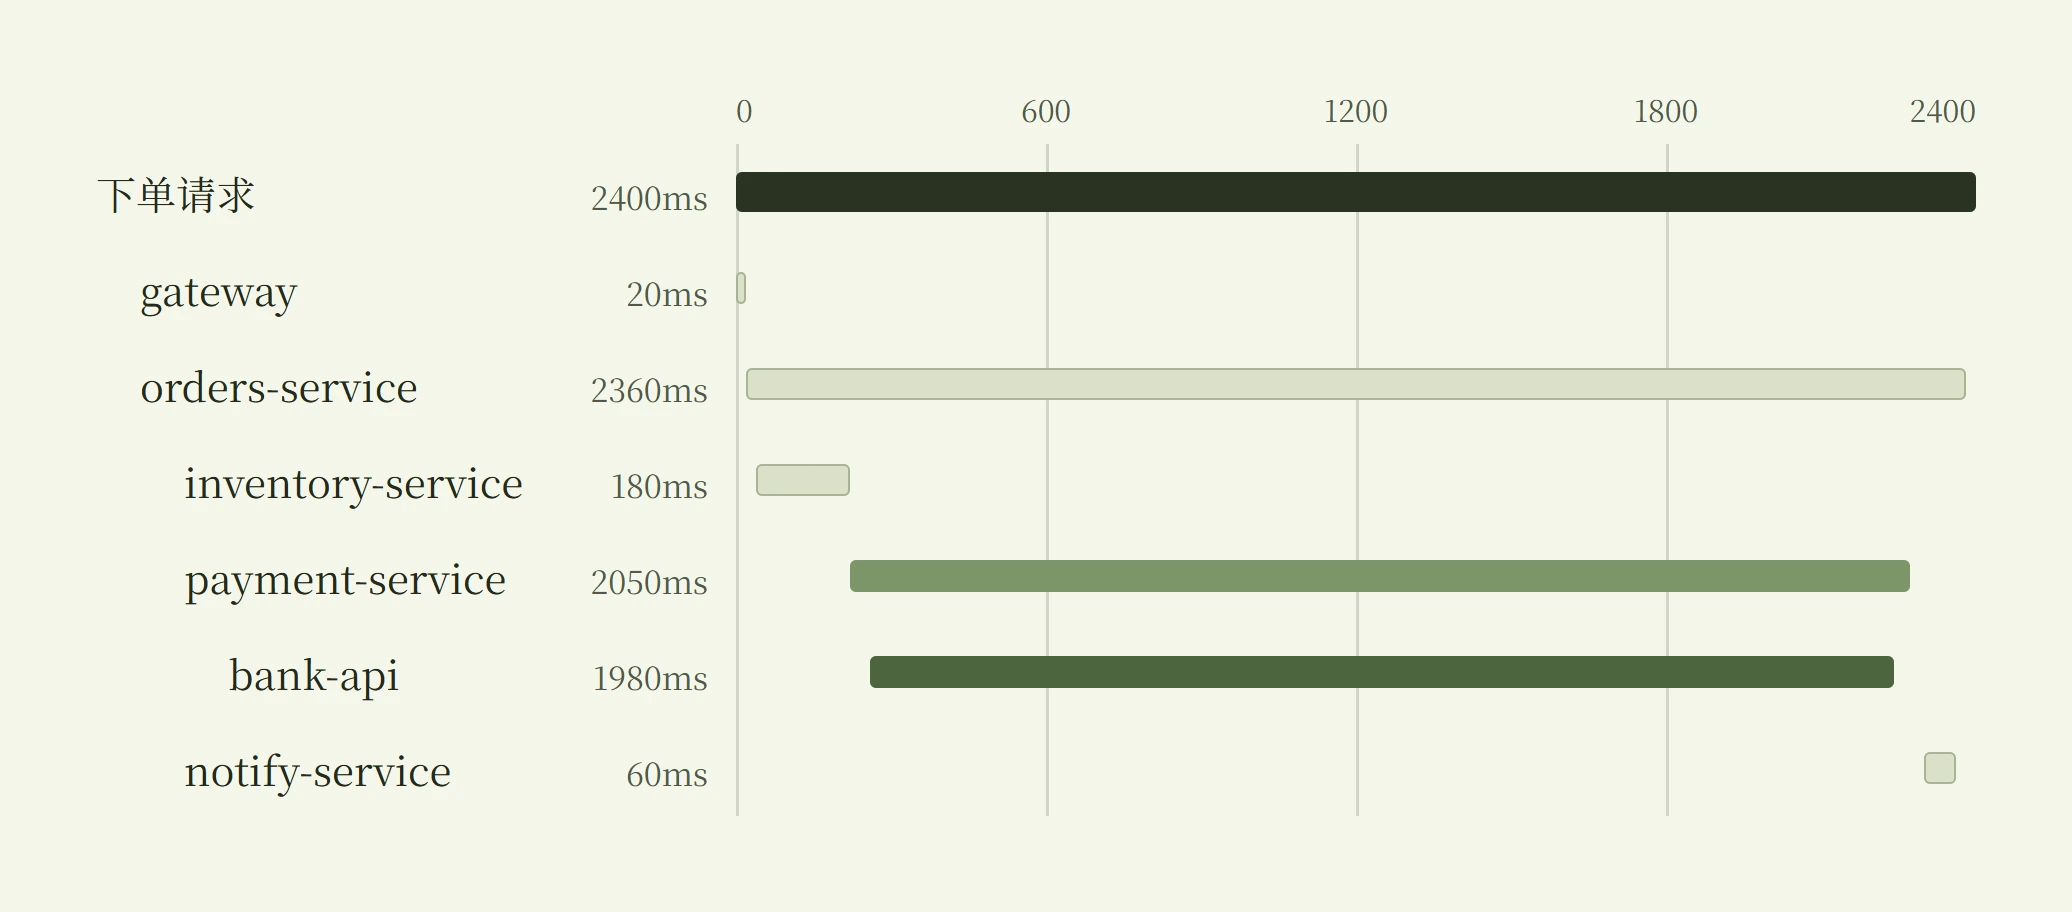
标准采集协议是 OpenTelemetry(OTel),现在是业界事实统一标准(把以前的 OpenTracing 和 OpenCensus 合并了)。
为什么这件事特别适合放在网格里做? 因为代理能自动给流量打标、传递头、上报 span,业务代码一行都不用改。否则每个团队要在每个服务里手动埋点,还容易漏。
4 代价
服务网格不是免费的:
资源与延迟:每个 Pod 多跑一个 Envoy,内存几十 MB 起、每跳多一到两次转发,延迟增加毫秒级——对高吞吐低延迟场景是实打实的成本。
运维复杂度上升:控制平面本身是高可用组件,它的配置错误可能让整个集群的通信全断。你为了降低复杂度引入了新的复杂度。
调试变难:请求被代理改过、重试过、加密过,抓包看到的是密文,“为什么这个请求失败了”反而更难回答。
因此出现了替代路线:
无边车(sidecar-less):把代理能力做进内核或节点级共享代理,如 Cilium Service Mesh(基于 eBPF,在节点甚至内核层做,不进 Pod);
类库路线(library):不搞代理,直接把治理做进 RPC 框架,如 gRPC 内置拦截器、Twitter 的 Finagle、Netflix 的 Hystrix(熔断的经典实现,现已停止维护)、阿里 Sentinel、腾讯 Polaris、字节 Kitex。这条路性能好、但绑语言——正是服务网格当初要摆脱的问题。
于是又出现 Proxyless 折中:控制平面照用,但由语言 SDK 直接对接控制平面,不要边车。
AI 声明 本文由作者撰写,AI 参与资料检索、润色与示例草稿。